
Группа компаний «Кирпич Холдинг» укрепила отраслевые позиции на Международной строительной неделе БРИКС в Казани
- 03 апреля 2020 22:20
- Новость
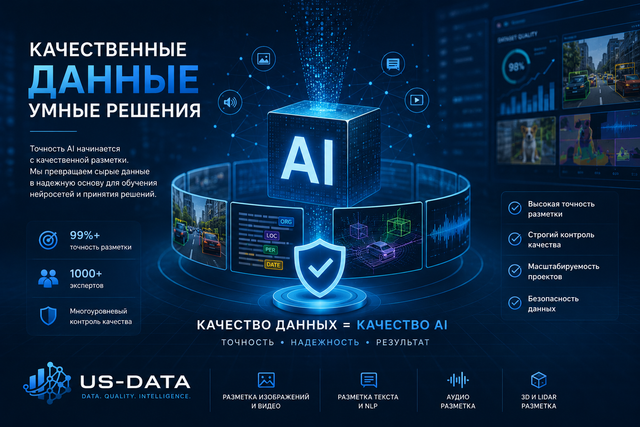
US-DATA: Без разметки данных искусственный интеллект бесполезен
Лента новостей
Сейчас искусственный интеллект внедряют практически во всех сферах — от банков и ритейла до промышленности и медицины. Компании инвестируют миллионы в нейросети, рассчитывая автоматизировать процессы, сократить расходы и ускорить принятие решений. Однако на практике многие AI-проекты сталкиваются с одной и той же проблемой: модели работают значительно хуже ожиданий.
Причина часто оказывается не в алгоритмах и не в вычислительных мощностях. Главная проблема — качество данных на которых обучается искусственный интеллект.
В индустрии AI давно существует принцип: garbage in — garbage out.
Если система обучается на ошибочных, неполных или хаотичных данных результат ее работы также будет содержать ошибки. Именно поэтому крупнейшие технологические компании мира инвестируют огромные ресурсы не только в разработку моделей, но и в подготовку датасетов.
Ключевую роль в этом процессе играет разметка данных — этап без которого современный AI фактически не способен обучаться.
Разметка данных представляет собой процесс подготовки информации для обучения нейросетей. Специалисты классифицируют изображения, размечают текст, выделяют объекты на видео помогают AI понимать контекст и закономерности. Именно на этом этапе модель начинает «понимать» что именно она анализирует.
По мере роста рынка искусственного интеллекта спрос на качественные данные начал расти быстрее чем возможности бизнеса их подготавливать. Компании столкнулись с дефицитом специалистов, высокой стоимостью подготовки датасетов и сложностью контроля качества.
На этом фоне начал активно развиваться рынок data labeling и инфраструктуры для подготовки AI-данных.
Одним из участников этого направления стала US-DATA — компания специализирующаяся на разметке и подготовке данных для обучения AI-моделей. Платформа работает с различными типами данных включая изображения, текст, аудио и видео, а также помогает автоматизировать процессы подготовки датасетов для задач компьютерного зрения, NLP и аналитики.
По словам участников рынка именно качество подготовки данных сегодня становится одним из ключевых факторов эффективности AI-систем. Даже современные модели начинают допускать ошибки, если обучаются на плохо структурированой информации.
Особенно критично это для отраслей где цена ошибки высока — например в медицине, промышленности, финансах или системах безопасности. В таких сферах требования к качеству данных и точности разметки продолжают расти.
Несмотря на развитие генеративного AI, полностью автоматизировать разметку рынок пока не может. Автоматические инструменты действительно ускоряют процессы однако без контроля качества модели начинают накапливать ошибки и искажения. Поэтому все больше компаний переходят к гибридной модели где AI помогает ускорять обработку информации, а финальную проверку выполняют специалисты.
На этом фоне рынок постепенно меняет отношение к самим AI-технологиям. Если еще несколько лет назад основное внимание уделялось вычислительным мощностям и самим нейросетям то сегодня все больше компаний приходят к выводу: конкурентное преимущество определяется прежде всего качеством данных.
Именно поэтому инфраструктура подготовки и разметки данных постепенно становится одной из ключевых основ современной AI-индустрии.
Рекомендуем:
Популярное
"19 лет без права на фальшь". Первые лица власти и бизнеса поздравляют Бизнес ФМ Уфа с Днём рождения
«Данные не совпадают». Эксперты о высоких ценах на икру в Уфе
Двух сотрудников УУНиТ отправили в СИЗО по делу о незаконном зачислении иностранцев
В Башкирии из-за непогоды начали ограничивать движение на дорогах
Директору ГКЗ «Башкортостан» Вильдану Яруллину продлили домашний арест

Последние новости